https://arxiv.org/abs/2509.18344, NeurIPS 2025 Published Paper
Abstract
메모리가 제한된 단일 GPU 환경에서 LLM을 추론하기 위해서 주로 다음 두 가지 접근법이 활용됨.
1) 모델 양자화(Quantization): 모델의 메모리 풋프린트를 줄일 수 있으나, 양자화 오차(Quantization Error)로 인한 생성 품질 저하가 발생할 수 있음.
2) 파라미터 오프로딩(Parameter Offloading): 품질 저하는 방지하지만, CPU-GPU 간 데이터 전송 병목으로 인해 추론 속도가 크게 저하됨.
Speculative Decoding (SD)은 오프로딩 환경에서 추론을 가속하기 위한 기법으로, 파라미터 수가 적은 Draft 모델과 원본 Target 모델로 구성됨. Draft 모델이 Autoregressive 방식으로 여러 개의 후보 토큰을 빠르게 생성하면, Target 모델이 이를 병렬로 검증(Verification)하여 최종 수용 여부를 결정함.
그러나 기존의 SD 기법은 Target 모델과 동일한 아키텍처를 공유하는 별도의 소형 Draft 모델을 요구함. 적합한 Draft 모델이 부재할 경우 추가적인 Training이 필수적이며, Target 모델과의 생성 분포 차이로 인해 Acceptance Rate가 제한되어 실질적인 속도 향상이 미미하다는 한계가 존재함.
본 논문에서는 이러한 한계를 극복하고 별도의 학습 없이(Training-free) 높은 가속 효율을 달성하는 SubSpec을 제안함. SubSpec은 CPU로 오프로딩된 Target 모델의 일부 레이어들을 저비트로 양자화하여 GPU에 적재한 뒤, 이를 Draft 모델의 레이어로 활용함. 이때, Target 모델의 비압축 레이어 및 과거 문맥을 담은 KV Cache를 Draft 과정과 공유함으로써 추가적인 메모리 오버헤드를 극소화하고, Target 모델과의 구조적 유사성을 유지해 Draft의 예측 정확도를 극대화함.
SubSpec은 한 번의 검증에서 평균적으로 많은 토큰을 수락받아, 8GB VRAM 환경에서 Qwen2.5 7B의 MT-Bench 생성 속도를 9.1배 향상시킴. 또한 24GB VRAM 환경에서는 Qwen2.5 32B의 주요 생성 벤치마크에서 평균 12.5배의 가속을 달성함.
Contribution
- 오프로딩 환경에 적합한 Draft 최적화 방식을 제시
Target 모델은 가중치를 가져오는 데 시간이 많이 걸리므로, 검증 한 번에 많은 토큰을 받아들이게 만드는 것이 중요함을 제안 - 추가학습 없는 Draft Model 제안
오프로딩한 layer는 quantization하여 draft용으로 사용하며, GPU에 있는 Weight와 KV Cache를 공유함. - 초안을 길게 생성할 때 유용한 후보 경로가 중간에 버려지는 문제를 줄임
여러 후보를 고르는 과정에서 Target이 선택할 가능성이 높은 경로를 더 오래 유지하도록 개선함. 이를 통해 검증 한 번에 accept되는 Token 수를 늘림 - 오프로딩 시스템에서 생성 속도 향상
GPU 계산 및 가중치 전송을 포함하는 최적화를 적용하고, 여러 모델 및 벤치마크에서 가속 효과를 검증
Introduction
큰 LLM을 로컬에서 실행하면 개인정보를 보호하고 모델을 자유롭게 수정할 수 있다는 장점이 있음. 하지만 일반적으로 모델 크기가 커서 일반적인 개인용 GPU의 메모리에서 활용하기는 어려운 상황임.
이를 해결하기 위해 양자화와 오프로딩 방식들이 제안되고 있지만, 이는 양자화 오차로 인한 성능 저하나 가중치 전송 반복문제로 인한 추론 속도 저하라는 각각의 한계가 존재함.
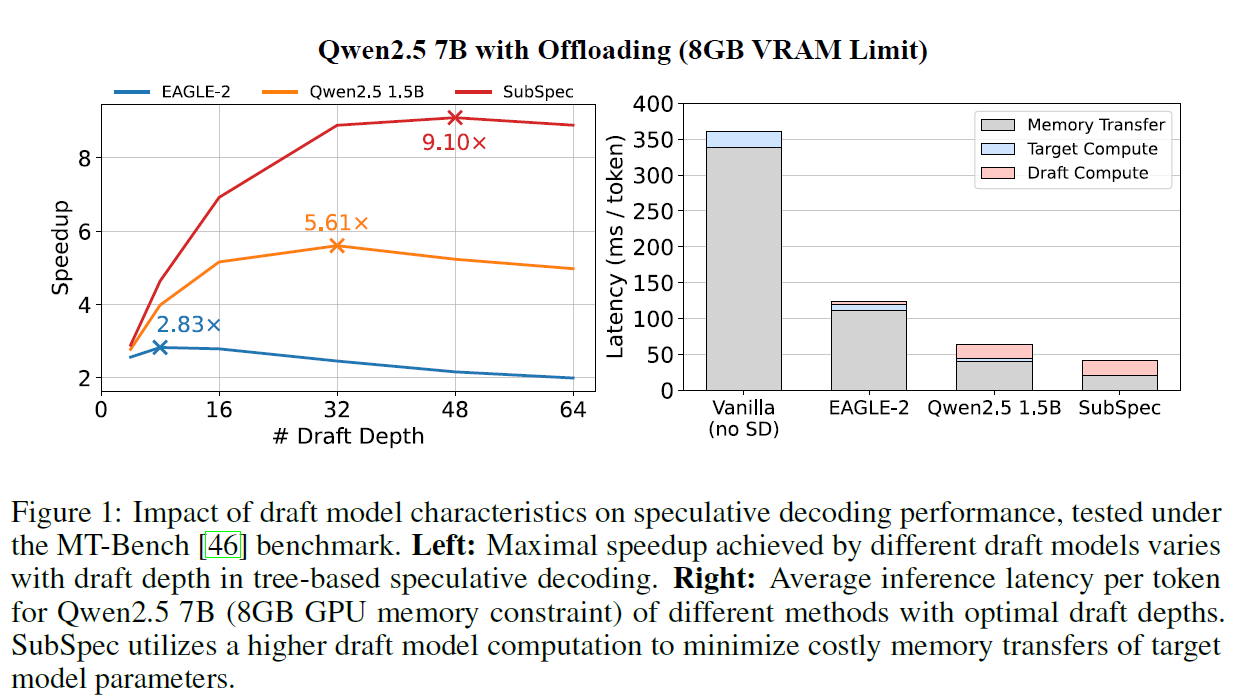
여기서 Speculative Decoding은 느린 가중치 전송 비용을 여러 토큰에 나누어 부담할 수 있음. Draft Model이 먼저 여러개의 후보 토큰을 생성하면, 이후 원본 target 모델이 한 번의 실행으로 여러 후보 토큰들을 검증함. 이때 후보 토큰 중 일부 토큰이 accept되면 Target 모델의 가중치를 한 번 가져온 것으로 여러 토큰을 생성하는 효과를 얻을 수 있음.
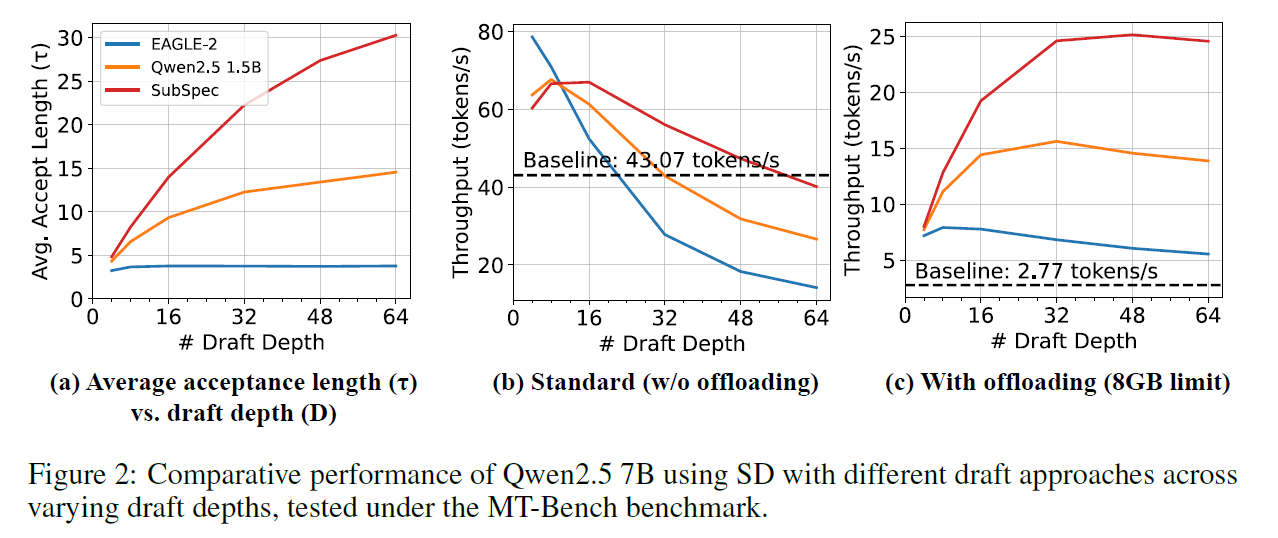
따라서, 오프로딩 환경에서는 원본(Target)의 예측을 잘 맞히는 Draft Model이 매우 중요함. Draft Model이 빠르게 실행되더라도 후보가 많이 거절되면, 검증을 위해 Target 모델을 자주 실행해야 하기 때문임. 반면, Draft가 조금 느리게 후보 토큰을 생성하더라도 많은 토큰이 accept되면, 비싼 target 모델의 실행 횟수를 줄여 전체 생성 속도를 높일 수 있음.
SD의 기존 방식들은 Draft 모델을 구성 시 Target 모델과 같은 계열의 소형 사전학습 모델을 사용함. 하지만 사용자가 맞춰 사용하기 위해서는 추가학습이 필요하다는 한계가 있음.
본 논문에서 제안하는 SubSpec은 원본 모델 자체를 활용해서 추가학습 없이 Draft 모델을 구성함.
Target 레이어를 양자화해 GPU에 올리고, 이를 Draft의 layer로 사용함. GPU에 이미 있는 Target model의 layer와 KV cache는 그대로 사용함. 이렇게 원본과 비슷하게 예측하는 Draft Model을 만들고, 더 먼 미래까지 후보를 많이 생성함. 이 방식을 통해 최종적으로 acceptance rate를 높이고 비싼 Target Model의 검증 횟수를 줄여 속도를 생상시킴.
Method
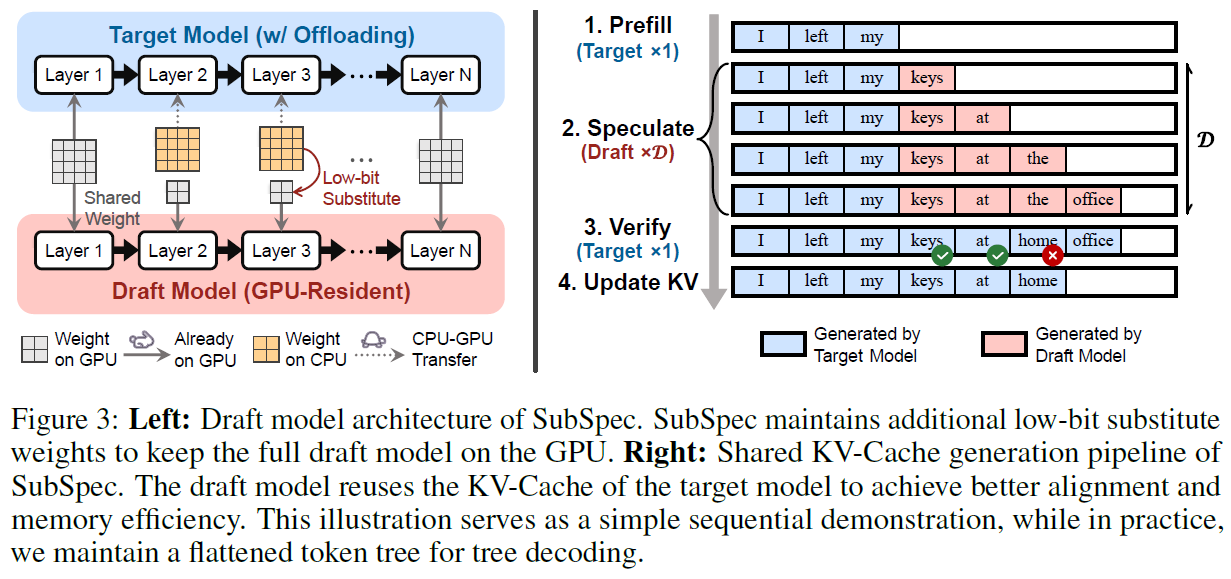
본 논문은 Target 모델 (큰 모델)의 가중치와 KV 캐시를 최대한 공유하면서 Draft 모델(작은 모델)은 GPU에서만 실행되도록 함
1) Draft Model
- Figure 3의 왼쪽 그림처럼, 이미 GPU에 상주하고 있는 원본 가중치 레이어를 Target Model과 Draft Model이 함께 사용함
- 반면 CPU에 있는 레이어는 Draft Model에서는 저비트로 양자화를 진행해 대체본으로 사용하며, Target Model에서는CPU의 원본 가중치를 가져옴
- 해당 과정을 통해 Draft Model은 CPU에서 가중치를 가져오는 과정 없이 전체 모델을 실행함. 또한, 원본 가중치를 공유하는 부분이 있기 때문에 Target과 비슷한 예측을 유도할 수 있음.
- 추가적으로 KV Cache도 공유하는데, Draft Model이 Target Model의 Cache를 그대로 이용하여 별도의 cache 저장 공간 없이 Draft 용 Prefill 비용을 줄일 수 있음
2) Token 생성과정 (Prefill →Speculate →Verify →Update KV)
- Figure 3의 오른쪽은 Token 생성의 네 단계를 보여줌. 여기서는 쉬운 이해를 위해 가장 높은 확률의 토큰을 선택하는 Greedy Decoding을 기준으로 설명함
- ① Prefill: 입력 문장 "I left my"가 있다고 가정할 때, 이는 Target 모델이 처리하고 KV Cache를 생성함. Draft 모델도 이 Cache를 사용하기 때문에 같은 입력을 다시 처리할 필요가 없음
- ② Speculate: Draft는 공유된 Cache를 기반으로 "keys at the office"라는 초안(후보 토큰들)을 순차적으로 생성함. 이때 원본 레이어와 저비트로 양자화된 대체 레이어가 모두 GPU에 있기 때문에, CPU와 GPU 사이의 가중치 전송은 발생하지 않음
- ③ Verify: Target 모델은 원본 가중치를 모두 사용해 후보 토큰들을 한 번의 Forward Pass로 검증함. Figure에서는 "keys at"까지만 accept하고, 다음 토큰으로는 Draft가 생성한 "the" 대신 home을 선택함. 따라서, 최종 문장은 "I left my keys at home"으로 확정되며, "the"가 거절되었기 때문에 그 뒤에 후보로 생성된 "office"도 사용되지 않음.
- ④ Update KV: Draft가 임시로 추가한 KV는 검증 과정에서 Target model이 계산한 값으로 덮어씀. 거절된 후보에 해당하는 부분은 제거함.
3) 더 많은 후보 토큰을 받아들이도록 깊은 후보 트리를 구성
- 후보 토큰을 받아들이는 비율을 Acceptance rate라고 함. Figure 3에서는 빠른 이해를 위해 초안 (후보 토큰)을 한줄로 그렸지만, 실제로는 여러 후보 경로가 갈라짐. 각 단게에서 후보 경로의 누적 확률을 계산하고, 점수가 높은 후보들을 남기면서 트리를 깊게 확장하는 방식을 본 논문에서는 채택함.
- 여기서 핵심은, 길게 생성한 초안을 Target이 얼마나 연속해서 받아들이느냐임. (Acceptance rate가 높아질수록 좋음)
본 논문의 저자들은 Target과 가까운 Draft를 구성하여, 한 번의 검증으로 확정되는 토큰 수를 늘리는 데 초점을 두었음. - 또한, 모든 가중치를 GPU에 상주시킬 수 없는 오프로딩 환경에서는 Target이 실행할 때마다 가중치 전송 비용이 발생함. 따라서 한 번에 많은 토큰을 확정하게 되면, 같은 길이의 답변을 생성하는데 필요한 Target 실행 횟수와 가중치 전송 횟수를 줄일 수 있음.
4) 실행 시간을 줄이기 위한 보조적인 최적화 방안 제안
- Asynchronous Data Transfer: 현재 레이어를 계산하는 동안 다음 레이어의 원본 가중치를 미리 가져와 계산과 전송과정을 겹치게 함.
- Chunked Prefill: 긴 입력을 여러 조각으로 나누어 처리함. 순간적인 GPU 메모리 사용량을 줄여 확보한 공간에 더 많은 Target 레이어를 유지함.
Experiment
실험은 RTX 4090환경에서 진행하였으며, GPU 메모리를 8·12·24GB로 제한함. 대화, 코드 생성, 수학 추론 등을 포함한 5개 벤치마크에서 일반 오프라인 추론, EAGLE-2, Family 계열의 소형 Draft 모델과 비교함.
메인 실험결과는 다음과 같음.
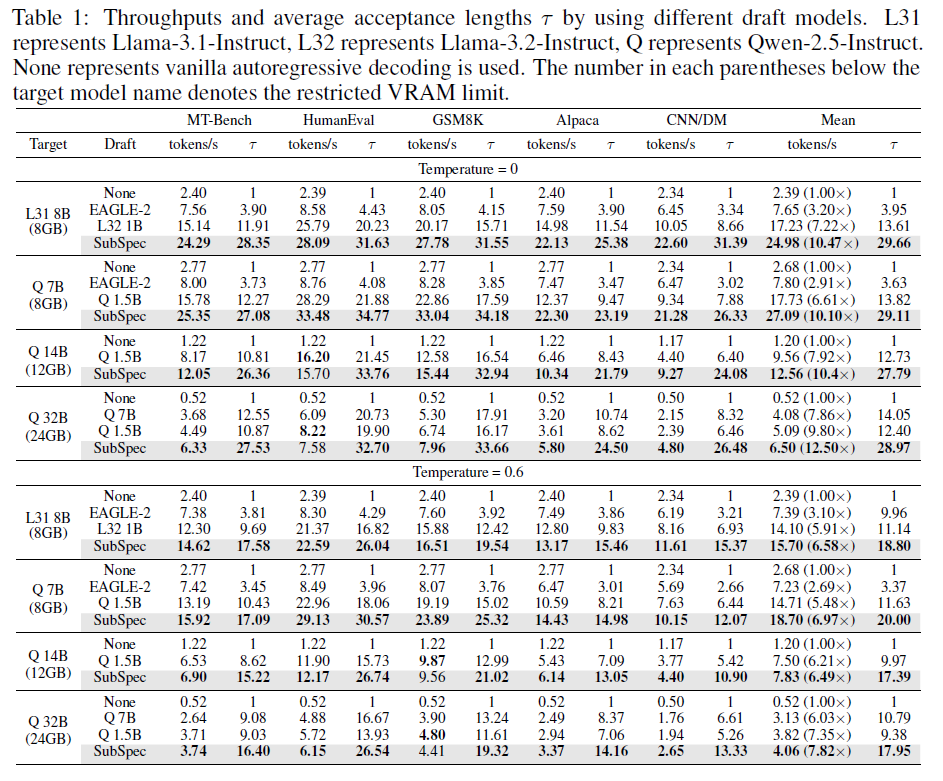
Greedy decoding에서 SubSpec (제안방식)은 일반 오프로딩 추론과 비교했을 때 평균적으로 약 10~12.5배의 속도 향상을 보임. $\tau$ (average acceptance length)의 경우에도 EAGLE-2와 소형 Draft 모델보다 높은 수치를 보임.
Target과 Draft가 가중치와 KV cache를 공유하는 구조가 acceptance rate를 높인 것으로 해석할 수 있으며, 비용이 큰 Target 모델 실행과 CPU-GPU 가중치 전송 반복 횟수 또한 절감한 것을 확인할 수 있음.
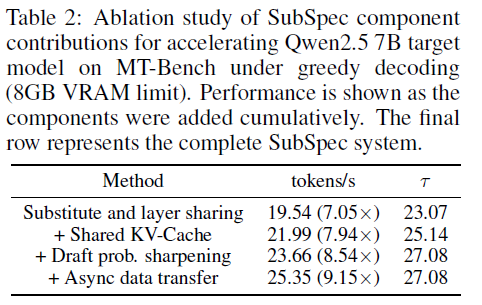
Ablation 실험결과에서는 KV cache 공유가 Probability를 sharpening 하는 방식이 acceptance rate를 향상 시킬 수 있었으며, 확률적 생성 (Async data transfer)는 acceptance rate를 유지하면서 초당 확정토큰 수를 늘릴 수 있는 방안임을 확인할 수 있음.
Conclusion
SubSpec은 원본 가중치와 KV Cache를 Draft-Target이 공유하며, 저비트의 대체 레이어 (Quantized Layer)를 활용하여, 별도 학습 없이 Target의 예측과 유사한 Draft를 구성함. Acceptance rate를 늘려 가중치 전송 횟수를 줄이며, 제한된 GPU 메모리에서도 원본 모델의 출력을 유지하며 오프로딩 추론을 가속화 함을 보여줌.
Strong Points
- 제한된 GPU 메모리 환경에서 발생할 수 있는 Speculative Decoding 관련 문제점을 지적하며, 이 원인을 적절하게 분석함. Target과 예측이 유사하도록 Draft Token을 생성하여 한 번 검증할때 확정될 수 있는 토큰 수를 늘렸으며, 비용이 큰 Target 모델의 실행을 줄이는 접근이 latency를 줄이는 데 적합한 방식이라고 생각함.
- Target이 계산한 KV를 Draft가 재사용하는 방식 또한 캐시의 중복 저장을 줄일 수 있음. Draft의 일부 레이어는 양자화되어 Target 모델의 FP layer 기반 KV가 적절하게 적용될 지 의문이었는데 실험결과를 통해 양자화된 레이어도 FP 레이어의 KV를 잘 반영한다는 사실을 알 수 있었음
- CPU에 있는 Target의 가중치는 Draft시 양자화되기 때문에 별도의 학습 데이터나 학습 과정이 필요하지 않음. 이 과정에서 지연시간이 발생하지 않는다는 점을 장점으로 생각함,
Weak Points
- KV cache는 문맥이 길어질수록 메모리 점유가 심해지나, 이 논문에서는 장문맥에서의 KV 캐시 공유 효과에 대해서는 제대로 다루지 않은 것으로 보임. 장문맥 처리의 경우 또 다른 연구분야로 확장될 여지가 존재하긴 하지만 장문맥 관련 한계에 대해서도 간단하게 언급했다면 좋았을 것 같음.
- 양자화를 진행한 레이어는 4-bit 설정으로만 평가하였음. 정밀도(precision)에 대한 상세한 실험결과가 부재해 Draft Model의 양자화 민감도에 대해 파악하기 어려웠음. 또한, 민감 부분에 대해서는 높은 정밀도로 유지하고, 민감하지 않은 부분에 대해서는 더 압축하는 방식을 채택하면 추가적인 이득이 있을 것으로 예상됨. (Ex. EAGLE-4에서는 LM head가 엄청난 시간병목의 원인임을 발표함)
- 제한된 메모리를 대상으로 하지만 최소 메모리 요구량이 높은 편임. 논문에서 저자들은 Qwen2.5-7B가 약 7.1GB의 최소 메모리가 필요하다고 주장함. 따라서 더 작은 메모리에서는 이 기술의 유효성을 판단하기 어렵다고 생각하며, 관련 ablation study가 추가적으로 있었으면 좋았을 것 같음.


